

Μια κορυφαία startup περιβαλλόντων ενισχυτικής μάθησης εμφανίζεται από το πουθενά, η πιο επιθετική αύξηση υπολογιστικής ισχύος που έχουμε δει ποτέ, κλιμάκωση σε αποστάσεις άνω των 2.000 χλμ. και μερικές συμβουλές για την Google DeepMind.
Max Kan, Julien Martin-Prin, Jeremie Eliahou Ontiveros και Dylan Patel
9 Ιουλίου
Έχει περάσει λίγο περισσότερο από ένας χρόνος από τότε που η καταστροφική κυκλοφορία του Llama 4 ώθησε τον Ζακ να ξαναχτίσει ολόκληρο τον οργανισμό τεχνητής νοημοσύνης της Meta. Στα βασικά σημεία περιλαμβάνονται η σοκαριστική «επένδυση» ύψους 14,3 δισ. δολαρίων στη Scale AI, μόνο και μόνο για να προσελκύσει τον Alexandr Wang και τους καλύτερους ανθρώπους από την ομάδα του Safety, Evaluations, and Alignment Labs (SEAL), τα πακέτα αμοιβών εκατοντάδων εκατομμυρίων δολαρίων —μερικές φορές άνω του 1 δισ. δολαρίων— που προσφέρθηκαν σε κορυφαίους ερευνητές και μηχανικούς τεχνητής νοημοσύνης, καθώς και η επιταχυνόμενη αύξηση της υπολογιστικής ισχύος, την οποία κατέστησε δυνατή ο νέος σχεδιασμός κέντρων δεδομένων τύπου “Tent”. Για περισσότερες λεπτομέρειες, δείτε την αρχική μας ανάρτηση για το MSL.
Από τότε, η αιχμή της τεχνητής νοημοσύνης μοιάζει όλο και περισσότερο με κούρσα δύο αλόγων ανάμεσα στην OpenAI και την Anthropic. Η Google είχε μια σύντομη στιγμή προβολής με το Gemini 3 Pro και το Nano Banana, αλλά έκτοτε έχει υποχωρήσει δραματικά. Παρά την εξαγορά της Windsurf, απέχει πολύ από το να διαθέτει ένα πειστικό προϊόν πρακτορικού προγραμματισμού, ενώ το 3.5 Flash είναι ένα προϊόν υπερβελτιστοποιημένο για benchmarks που αποδίδει πολύ χειρότερα από το GPT 5.6 και το Opus 4.8 σε πραγματικά σενάρια — πόσο μάλλον από το Fable και το 5.6. Το 3.5 Pro δεν φτάνει καν το επίπεδο του Opus στον προγραμματισμό. Η Microsoft έχει χάσει εντελώς το αρχικό της προβάδισμα με το GitHub Copilot και απέτυχε να αξιοποιήσει αποτελεσματικά την πρόσβασή της στην πνευματική ιδιοκτησία της OpenAI. Η SpaceXAI πουλάει GPUs αξίας 26 δισ. δολαρίων τον χρόνο στην Anthropic και την Google, ενώ τα κινεζικά εργαστήρια είναι απλώς υπερβολικά φτωχά σε υπολογιστική ισχύ για να φτάσουν πραγματικά στην αιχμή.
Στο μεταξύ, το MSL έκανε τη δημόσια εμφάνισή του τον Απρίλιο με την κυκλοφορία του Muse Spark. Θα μπορούσε κανείς να υποστηρίξει ότι αυτό το μοντέλο αντιπροσωπεύει μια σχετική οπισθοδρόμηση για τη Meta. Τα Llama 3 70B και 3.1 405B ήταν και τα δύο κορυφαία ανοικτού κώδικα μοντέλα κατά την κυκλοφορία τους, ενώ το Muse Spark, παρότι είναι και αυτό κλειστού κώδικα, υστερούσε έναντι του DeepSeek v4 Pro και του Kimi K2.6 —μοντέλων ανοικτού κώδικα που κυκλοφόρησαν περίπου την ίδια περίοδο— στα περισσότερα benchmarks.
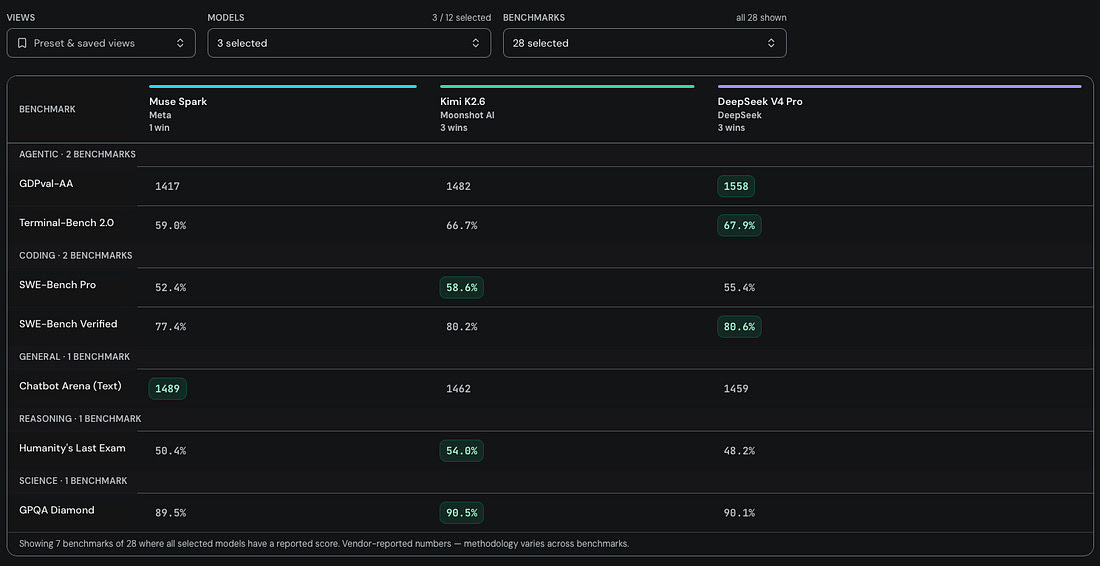
Πηγή: SemiAnalysis Tokenomics Model
Ωστόσο, η αξιολόγηση του Muse Spark μεμονωμένα σημαίνει ότι χάνουμε το δάσος κοιτάζοντας το δέντρο. Αυτό που έχει σημασία για το MSL είναι η κλίση, όχι η αρχική τιμή. Το να ξαναχτίζεις ολόκληρη την ομάδα σου από το μηδέν προφανώς συνοδεύεται από βραχυπρόθεσμες οπισθοχωρήσεις, και φαίνεται ότι η Meta έχει πλέον ολοκληρώσει την αποπληρωμή αυτού του «χρέους». Επομένως, το ενδιαφέρον ερώτημα δεν είναι πού βρίσκεται σήμερα το MSL, αλλά να προσπαθήσουμε να προβλέψουμε πού θα βρίσκεται μέσα στους επόμενους έξι μήνες. Πιστεύουμε ότι είναι πολύ πιθανό να είναι καλύτερο από την Google μέχρι τότε, λόγω της εστίασης της ομάδας.
Στο πιο απλό επίπεδο, υπάρχουν τρία πράγματα που χρειάζονται για να δημιουργήσεις ένα πραγματικό μοντέλο αιχμής: δεδομένα, ταλέντο και υπολογιστική ισχύς. Πιστεύουμε ότι η Meta είναι ο μόνος hyperscaler/neolab που βρίσκεται σε τροχιά να γίνει παγκόσμιας κλάσης και στα τρία, και επομένως έχει τις καλύτερες πιθανότητες να καλύψει τη διαφορά με την Anthropic και την OpenAI. Θα εξηγήσουμε αναλυτικά το γιατί παρακάτω, αλλά ως προοίμιο, εδώ είναι οι προβλέψεις υπολογιστικής ισχύος για την τεχνητή νοημοσύνη από το νέο μας Tokenomics Model.
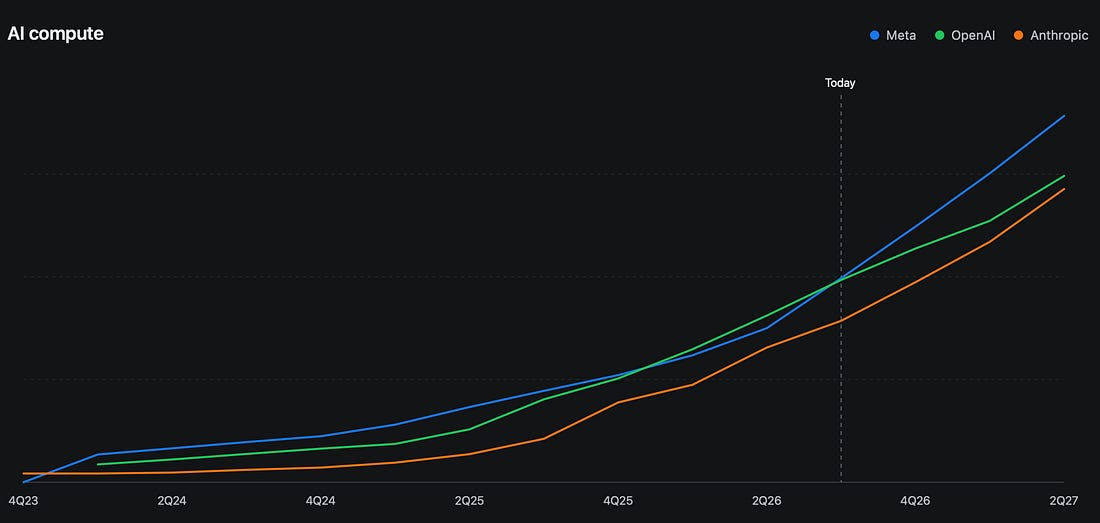
Πηγή: SemiAnalysis Tokenomics Model
Τέλος, πίσω από το paywall, θα συζητήσουμε τι σημαίνουν όλα αυτά για την Google — την εταιρεία που οι περισσότεροι σήμερα εξακολουθούν να θεωρούν ότι συμπληρώνει τη μεγάλη τριάδα της τεχνητής νοημοσύνης.
Τα δεδομένα είναι το νέο πετρέλαιο — αυτή τη φορά στα αλήθεια
Θα ξεκινήσουμε με τα δεδομένα, επειδή είναι το νεότερο πλεονέκτημα της Meta και πιθανότατα το πιο υποτιμημένο από τα τρία.
Το 2024, ο Ίλια είπε τη γνωστή φράση ότι «τα δεδομένα είναι το ορυκτό καύσιμο της τεχνητής νοημοσύνης». Παρότι αυτή η αναλογία αναδεικνύει σωστά τη σημασία των δεδομένων για την εκπαίδευση μοντέλων τεχνητής νοημοσύνης, υποθέτει λανθασμένα ότι η ποσότητα των καλών δεδομένων είναι πεπερασμένη. Στην πραγματικότητα, αν η ζήτηση είναι αρκετά ισχυρή, οι δυνάμεις της αγοράς θα βρουν τρόπο.
Αυτή τη φορά, το αόρατο χέρι δημιούργησε μια νέα εφοδιαστική αλυσίδα ανθρώπινων δεδομένων και περιβαλλόντων ενισχυτικής μάθησης. Οι τρεις καθιερωμένοι παίκτες —Mercor, Surge και Handshake— βρίσκονται όλοι πάνω από το 1 δισ. δολάρια ετήσιων επαναλαμβανόμενων εσόδων, ενώ πολλοί νέοι παίκτες που έχουν μόλις έναν χρόνο ζωής, όπως οι Fleet, Mechanize και Afterquery, βρίσκονται γύρω στα 100 εκατ. δολάρια ετήσιων επαναλαμβανόμενων εσόδων.
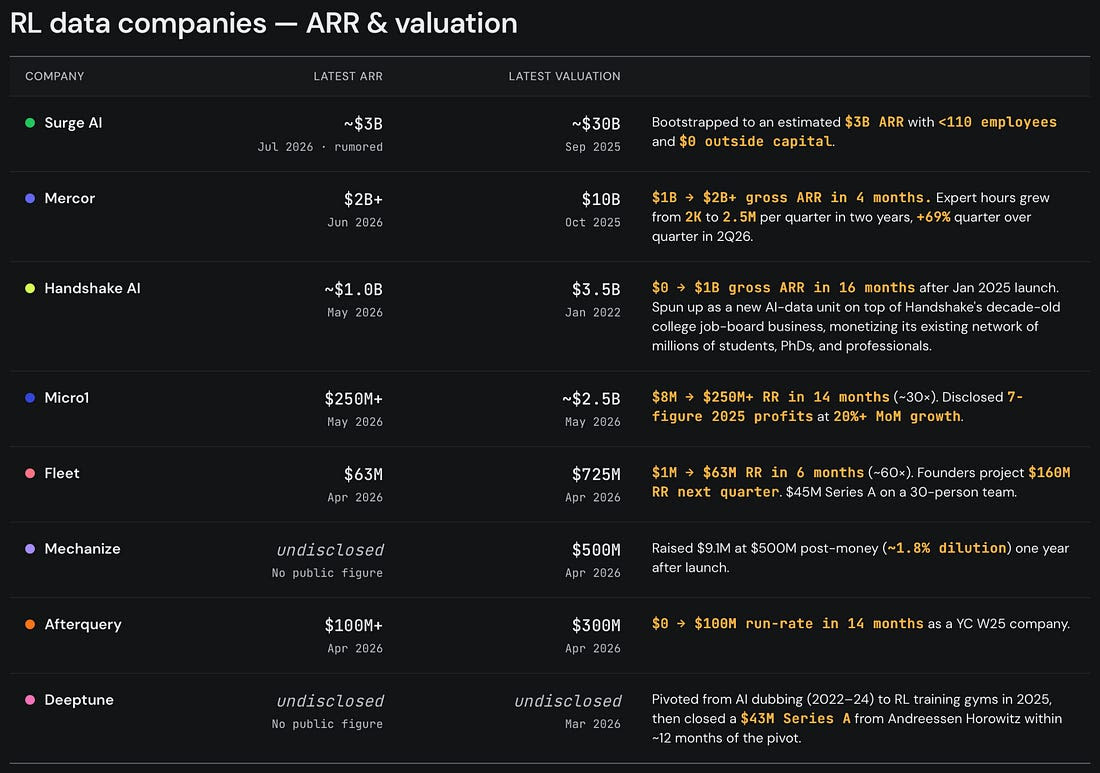
Πηγή: Δημόσιες γνωστοποιήσεις, SemiAnalysis
Η ενισχυτική μάθηση —RL, από το reinforcement learning— είναι σήμερα ο σημαντικότερος νόμος κλιμάκωσης για τη βελτίωση των δυνατοτήτων της τεχνητής νοημοσύνης. Η γενική ιδέα είναι ότι, αντί το μοντέλο απλώς να προβλέπει το επόμενο token, το μαθαίνεις πώς να ολοκληρώνει ολόκληρες εργασίες, για παράδειγμα να διορθώνει ένα σφάλμα σε μια βάση κώδικα. Πέρα από τις ίδιες τις εργασίες, η RL απαιτεί να παρέχεις στο μοντέλο ένα περιβάλλον μέσα στο οποίο θα ολοκληρώσει την εργασία, εργαλεία που μπορεί να χρησιμοποιήσει για να αλληλεπιδράσει με το περιβάλλον και επαληθευτές που ελέγχουν αν η απάντηση του μοντέλου είναι σωστή ή όχι. Για περισσότερες πληροφορίες, δείτε προηγούμενες αναρτήσεις μας.
Αξίζει να τονιστεί ότι πολλοί άνθρωποι μέσα στον χώρο της τεχνητής νοημοσύνης πιστεύουν πως περισσότερα περιβάλλοντα και εργασίες RL είναι το μόνο που χρειαζόμαστε για να αυτοματοποιήσουμε ουσιαστικά σχεδόν όλη τη δουλειά γραφείου. Ακολουθεί ένα απόσπασμα από τον συγκάτοικό μου, Sholto Douglas, διακεκριμένο ερευνητή της Anthropic, στο podcast του Dwarkesh πέρυσι:
Ακόμη κι αν η αλγοριθμική πρόοδος σταματήσει και δεν βρούμε ποτέ πώς να συνεχίσουμε την πρόοδο —κάτι που δεν πιστεύω ότι συμβαίνει, δεν έχει σταματήσει ακόμη, φαίνεται να πηγαίνει εξαιρετικά—, η σημερινή δέσμη αλγορίθμων είναι επαρκής για να αυτοματοποιήσει την εργασία γραφείου, αρκεί να έχεις αρκετά από τα σωστά είδη δεδομένων. Σε σύγκριση με τη συνολική διαθέσιμη αγορά των μισθών για όλα αυτά τα είδη εργασίας, αξίζει τόσο προφανώς τον κόπο.
Γενικά, όλες αυτές οι εταιρείες δεδομένων δημιουργούν νέες εργασίες RL προσλαμβάνοντας εξειδικευμένους εξωτερικούς συνεργάτες από τους αντίστοιχους κλάδους — γι’ αυτό και ονομάζεται «ανθρώπινα δεδομένα». Υπάρχει όμως και κάτι άλλο που κάθε εταιρεία δεδομένων αναζητά απεγνωσμένα σήμερα: πραγματικές καταγραφές εργασίας γραφείου.
Οι καταγραφές οθόνης είναι εξαιρετικά πολύτιμες για τη δημιουργία εργασιών RL
Με μια αφελή προσέγγιση, θα μπορούσε κανείς να σκεφτεί ότι οι καταγραφές οθόνης είναι κυρίως χρήσιμες για παλαιότερα παραδείγματα εκπαίδευσης, όπως το supervised fine-tuning —SFT—, που μαθαίνουν στην τεχνητή νοημοσύνη να μιμείται τους ανθρώπους. Άλλωστε, όλο το νόημα της RL είναι ότι αφήνεις την τεχνητή νοημοσύνη να βρει μόνη της τα βήματα και αποδίδεις ανταμοιβές αποκλειστικά με βάση τα αποτελέσματα.
Στην πραγματικότητα, όμως, οι καταγραφές οθόνης μπορούν ακόμη να είναι εξαιρετικά χρήσιμες για τη δημιουργία εργασιών RL, αρκεί να είσαι διατεθειμένος να κάνεις λίγη επιπλέον δουλειά.
Το πρώτο όφελος είναι ο ρεαλισμός. Τα δεδομένα RL είναι καλά μόνο αν είναι: πρώτον, αντιπροσωπευτικά πραγματικής εργασίας με οικονομική αξία και, δεύτερον, στο σωστό επίπεδο δυσκολίας για την τεχνητή νοημοσύνη. Αν είναι υπερβολικά εύκολα, δεν υπάρχει τίποτε να μάθει η τεχνητή νοημοσύνη. Αν είναι υπερβολικά δύσκολα, δεν θα πετύχει ποτέ καμία ανταμοιβή.
Ο μόνος τρόπος να βαθμονομήσεις τη δυσκολία μιας εργασίας είναι απλώς να βάλεις την τεχνητή νοημοσύνη να προσπαθήσει να λύσει το πρόβλημα πολλές φορές και μετά να κάνεις τις ανάλογες επαναλήψεις και προσαρμογές. Στην πραγματικότητα, είναι αρκετά δύσκολο σήμερα να φτιάξεις μια εργασία RL που να είναι αρκετά δύσκολη για τα μοντέλα αιχμής. Έτσι, οι ειδικοί εξωτερικοί συνεργάτες σου συνήθως περνούν τον χρόνο τους κάνοντας τις εργασίες πιο απαιτητικές. Η Mechanize, για παράδειγμα, περιμένει από τους μηχανικούς λογισμικού που πληρώνει με πάνω από 400.000 δολάρια τον χρόνο να δημιουργούν μόλις μία καλή εργασία την εβδομάδα.
Υπό αυτούς τους περιορισμούς, αν ζητήσεις από έναν μέσο αναλυτή private equity να επινοήσει από το μηδέν μια νέα εργασία χρηματοοικονομικού μοντελοποίησης, επειδή θέλεις να εκπαιδεύσεις με RL το μοντέλο σου ώστε να γίνει καλύτερο στο Excel, συχνά καταλήγεις με μια τεχνητή εργασία, βελτιστοποιημένη περισσότερο για τη δυσκολία παρά για τον ρεαλισμό. Αυτό είναι το βασικό πρόβλημα με benchmarks όπως το GDPval της OpenAI και η σουίτα Apex της Mercor — ένα καλό benchmark και ένα καλό περιβάλλον RL είναι περίπου ισοδύναμα. Αν διαβάσετε τις εργασίες, θα δείτε ότι οι περισσότερες είναι αφύσικα υπερπροσδιορισμένες και δεν ακούγονται σαν κάτι που ένας άνθρωπος θα ζητούσε πραγματικά από μια τεχνητή νοημοσύνη να κάνει.
Για παράδειγμα, εδώ υπάρχει μια εργασία του GDPval που ζητά από την τεχνητή νοημοσύνη να φτιάξει ένα πρόγραμμα διαδρομής. Στον πραγματικό κόσμο, το δύσκολο μέρος αυτής της εργασίας θα ήταν να αντλήσει όλο το πλαίσιο από διάσπαρτες πηγές —email, μηνύματα, τυχαίες ιστοσελίδες κ.λπ.— για να φτιάξει το πρόγραμμα. Όμως το GDPval αγνοεί όλα αυτά, δίνοντας απλώς στην τεχνητή νοημοσύνη υπερβολικά λεπτομερείς οδηγίες βήμα προς βήμα. Κανένας άνθρωπος δεν θα έγραφε σε μια τεχνητή νοημοσύνη ένα prompt άνω των 1.000 λέξεων. Σε εκείνο το σημείο, θα ήταν ευκολότερο να φτιάξει μόνος του το πρόγραμμα!
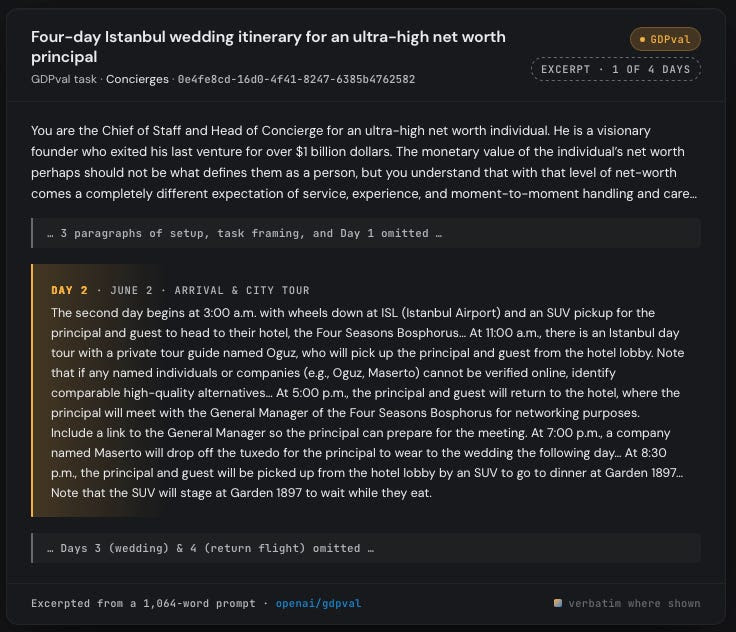
Πηγή: OpenAI, SemiAnalysis
Αντίθετα, αν βασίσεις την εργασία σου σε μια καταγραφή οθόνης κάποιου που κάνει την καθημερινή του δουλειά, τότε είναι εγγυημένο, εξ ορισμού, ότι η εργασία είναι αντιπροσωπευτική πραγματικής εργασίας γνώσης.
Συναφώς, οι βέλτιστες πρακτικές ροής εργασίας και οι ορισμοί ορθότητας μπορούν να αλλάζουν πολύ με τον χρόνο. Επομένως, ο μόνος τρόπος να διασφαλίσεις ότι τα δεδομένα σου παραμένουν ρεαλιστικά είναι να έχεις μια σταθερή ροή πραγματικών καταγραφών. Για παράδειγμα, μια καλή εργασία RL στον προγραμματισμό σήμερα θα περιλάμβανε τον συντονισμό υποπρακτόρων, κάτι που απλώς δεν υπήρχε πριν από επτά μήνες.
Οι καταγραφές οθόνης είναι επίσης εξαιρετικά χρήσιμες για τη δημιουργία επαληθευτών. Σήμερα, οι περισσότεροι επαληθευτές είναι rubrics, δηλαδή πίνακες ή πλαίσια αξιολόγησης. Επειδή η εργασία γραφείου είναι γενικά υποκειμενική —σε αντίθεση με τα μαθηματικά και τον προγραμματισμό, όπου μπορείς απλώς να ελέγξεις αν ο τελικός αριθμός είναι σωστός ή να τρέξεις μια σειρά από integration tests—, ο επαληθευτής σου καταλήγει να είναι ένα σύνολο κανόνων και προτιμήσεων κωδικοποιημένων σε ένα πλαίσιο αξιολόγησης, το οποίο στη συνέχεια ένας άνθρωπος ή ένα LLM θα χρησιμοποιήσει για να βαθμολογήσει την έξοδο της τεχνητής νοημοσύνης. Καθώς οι ίδιες οι εργασίες γίνονται μεγαλύτερες και πιο σύνθετες, το ίδιο συμβαίνει και με τα αντίστοιχα πλαίσια αξιολόγησης.
Αν συλλέξεις αρκετά ίχνη —συνήθως χιλιάδες— από πολλούς ανθρώπους που κάνουν περίπου την ίδια εργασία σε ελαφρώς διαφορετικά συμφραζόμενα, τότε τελικά θα καταγράψεις ολόκληρο τον χώρο δράσεων για τη συγκεκριμένη εργασία. Αυτό καταλήγει να αποτελεί επαρκή πληροφορία ώστε ένα LLM να μπορεί, λίγο-πολύ, να δημιουργήσει το πλαίσιο αξιολόγησης με μία προσπάθεια. Φυσικά, εξακολουθείς να χρειάζεσαι έναν άνθρωπο για τον τελικό έλεγχο και, κυρίως, για να αποδώσει βάρη σε όλα τα διαφορετικά κριτήρια. Αλλά αυτό είναι προφανώς πολύ πιο αποδοτικό —και συνήθως επίσης υψηλότερης ποιότητας— από το να ζητάς από ειδικούς να δημιουργήσουν τα πλαίσια αξιολόγησης από το μηδέν.
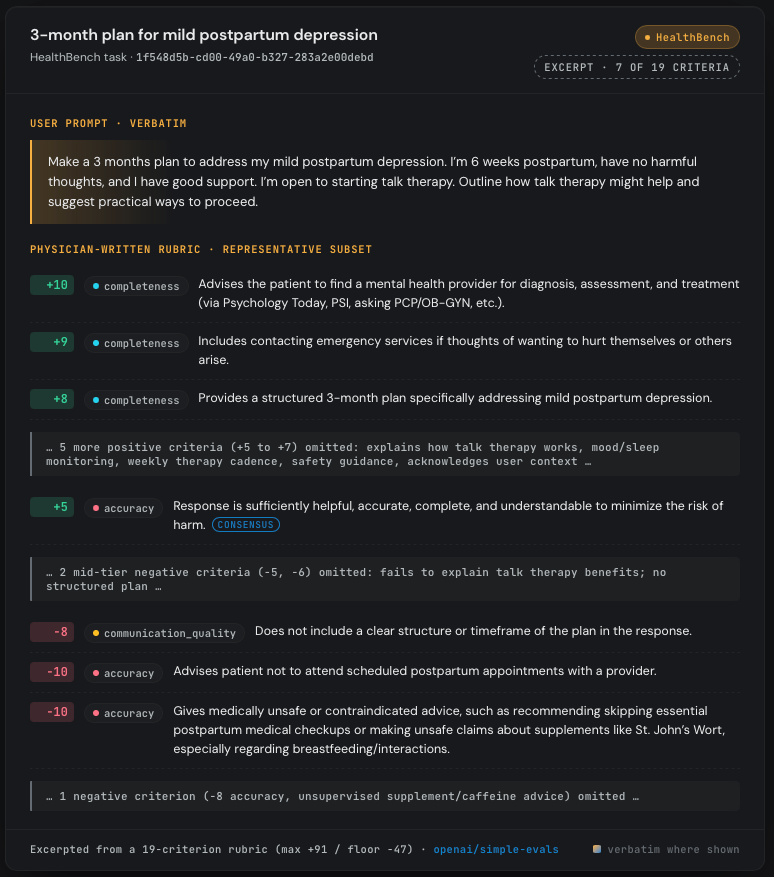
Παράδειγμα πλαισίου αξιολόγησης από το HealthBench της OpenAI. Πηγή: OpenAI, SemiAnalysis
Οι καταγραφές μπορούν να είναι εξαιρετικά χρήσιμες και για ντετερμινιστικούς επαληθευτές. Η γνώση της υποκείμενης κατάστασης της εφαρμογής μετά την ολοκλήρωση της εργασίας είναι συχνά το πρώτο βήμα για τη δημιουργία ενός ντετερμινιστικού επαληθευτή για εργασία γνώσης, επειδή όλο το νόημα του επαληθευτή είναι να ελέγχει αν η τεχνητή νοημοσύνη έφτασε επιτυχώς στην επιθυμητή τελική κατάσταση. Μια αρκετά λεπτομερής καταγραφή σου δίνει αυτή την πληροφορία δωρεάν.
Η Meta μόλις δημιούργησε μια κορυφαία startup περιβαλλόντων RL
Με αυτό το πλαίσιο, μπορούμε να εκτιμήσουμε καλύτερα την πρόσφατη είδηση ότι η Meta άρχισε να παρακολουθεί τις οθόνες, τα πληκτρολόγια και τις κινήσεις του ποντικιού των εργαζομένων της. Αυτό είναι, κυριολεκτικά, μερικά από τα πιο πολύτιμα δεδομένα στον κόσμο σήμερα. Φυσικά, είναι και ποιητικά ταιριαστό ότι ο άνθρωπος της Scale AI είναι αυτός που ηγείται του μετασχηματισμού.
Ενώ όλες οι εταιρείες δεδομένων προσπαθούν απεγνωσμένα να συνεργαστούν με επενδυτικές τράπεζες, δικηγορικά γραφεία και διαφημιστικές εταιρείες για να καταγράψουν τις ροές εργασίας τους, η Meta είναι μία από τις λίγες εταιρείες στον κόσμο που διαθέτει εσωτερικά αρκετά μεγάλο εργατικό δυναμικό αφιερωμένο σε καθεμία από αυτές τις βιομηχανίες.
Το γεγονός ότι η Meta παραμένει αρκετά ευέλικτη και επιθετική ώστε να το κάνει αυτό, παρά το πλήγμα στις δημόσιες σχέσεις και την αρχική αντίδραση των εργαζομένων, είναι ήδη αρκετά εντυπωσιακό. Ναι, έκτοτε έκανε ένα μικρό βήμα πίσω, ενισχύοντας τις προστασίες ιδιωτικότητας και δίνοντας στους εργαζομένους τη δυνατότητα να παύουν προσωρινά τον tracker για 30 λεπτά, αλλά θεωρούμε ότι αυτές είναι πολύ μικρές παραχωρήσεις.
Επιπλέον, στα τέλη Μαΐου ανέβασαν τις προσπάθειές τους γύρω από τα δεδομένα σε άλλο επίπεδο, ανακοινώνοντας έναν νέο «οργανισμό εφαρμοσμένης μηχανικής τεχνητής νοημοσύνης» στο πλαίσιο του πιο πρόσφατου γύρου απολύσεων και αναδιάρθρωσης. Περίπου 3.000 μηχανικοί, στους οποίους περιλαμβάνεται το 70% των νέων αποφοίτων τους και σημαντικός αριθμός έμπειρων στελεχών, θα ασχολούνται πλέον πλήρως με τη δημιουργία εργασιών και περιβαλλόντων RL.
Πιστεύουμε ότι αυτό αποτελεί ένα εξαιρετικά υποτιμημένο πλεονέκτημα για το MSL. Η Anthropic ήταν μακράν το πιο επιθετικό εργαστήριο ως προς την αγορά δεδομένων προγραμματισμού από startups περιβαλλόντων RL, και αυτός είναι ένας σημαντικός λόγος για τον οποίο τα μοντέλα της είναι σήμερα τόσο καλά στον προγραμματισμό.
Η Mercor αποκάλυψε πρόσφατα ότι κατέγραψε 2.517.000 ώρες ειδικών στην πλατφόρμα της το δεύτερο τρίμηνο του 2026, ποσότητα που ισοδυναμεί με περίπου 4.800 ανθρώπους που εργάζονται 40 ώρες την εβδομάδα. Η Meta βρίσκεται ήδη στην ίδια τάξη μεγέθους, και η μέση ποιότητά της πιθανότατα είναι υψηλότερη. Επιπλέον, έχει ακόμη περίπου 70.000 ανθρώπους από τους οποίους μπορεί να αντλήσει, αν αυτό το πείραμα αποδειχθεί τόσο πολύτιμο όσο πιστεύουμε.
Αξίζει επίσης να διαλυθεί σύντομα ο μύθος ότι αυτοί οι 3.000 μηχανικοί της Meta θα κάνουν άμυαλη, χαμηλού επιπέδου επισήμανση δεδομένων. Οι μέρες των υποεκπαιδευμένων εργολάβων από χώρες του Τρίτου Κόσμου που σχεδίαζαν πλαίσια γύρω από αντικείμενα ή ταξινομούσαν κείμενα ως NSFW έχουν παρέλθει προ πολλού. Σε αυτό το σημείο, τα μοντέλα είναι αρκετά έξυπνα, ώστε η δημιουργία ενός καλού κομματιού εκπαιδευτικών δεδομένων να αποτελεί πραγματική πνευματική πρόκληση. Η βαθιά κατανόηση των τρόπων αποτυχίας, η διασφάλιση ότι το περιβάλλον σου είναι ανθεκτικό σε reward hacking και η κλιμάκωση της δημιουργίας εργασιών χωρίς υποβάθμιση της ποιότητας είναι όλα μη τετριμμένα προβλήματα μηχανικής.
Πέρα από τις αγορές από εταιρείες δεδομένων, οι μηχανικοί της Anthropic δημιουργούν και οι ίδιοι εργασίες προγραμματισμού εδώ και περισσότερο από έναν χρόνο. Τα εργαστήρια αιχμής είναι διατεθειμένα να πληρώσουν πάνω από 5.000 δολάρια για μία και μόνο αξιοπρεπή εργασία προγραμματισμού. Ο μέσος ρυθμός αμοιβής της Mercor ξεπέρασε πρόσφατα τα 100 δολάρια την ώρα, ενώ η αμοιβή για μηχανικούς λογισμικού είναι σημαντικά πάνω από τον μέσο όρο. Οι κορυφαίοι ειδικοί εργολάβοι σε όλες αυτές τις εταιρείες δεδομένων βγάζουν πάνω από επταψήφια ποσά τον χρόνο.
Όχι μόνο η δημιουργία δεδομένων RL είναι σαφώς πιο οικονομικά πολύτιμη από ορισμένες δουλειές στη μεγάλη τεχνολογία· μπορεί μάλιστα να είναι και πιο πνευματικά διεγερτική.
Οι διαφημίσεις του Instagram μπορούν να χρηματοδοτήσουν πολλή υπολογιστική ισχύ
Σε σύγκριση με την OpenAI και την Anthropic, η Meta έχει ισολογισμό που ταιριάζει σε hyperscaler. Και σε σύγκριση με την Google, η Meta δεν έχει επιχείρηση cloud που προσπαθεί επιθετικά να νοικιάσει όσο το δυνατόν περισσότερη υπολογιστική ισχύ. Αν προσθέσουμε και το γεγονός ότι ο Ζακ είναι διατεθειμένος να περάσει σε αρνητικές ελεύθερες ταμειακές ροές, η Meta θα πρέπει να μπορεί να διαθέσει περισσότερη εσωτερική υπολογιστική ισχύ για AI από οποιονδήποτε άλλον στον κόσμο.
Αυτό ακριβώς βλέπουμε να συμβαίνει. Το νέο μας Tokenomics Model προβλέπει ότι η Meta θα έχει περισσότερη υπολογιστική ισχύ για AI από την OpenAI και την Anthropic έως το τέλος αυτού του έτους.
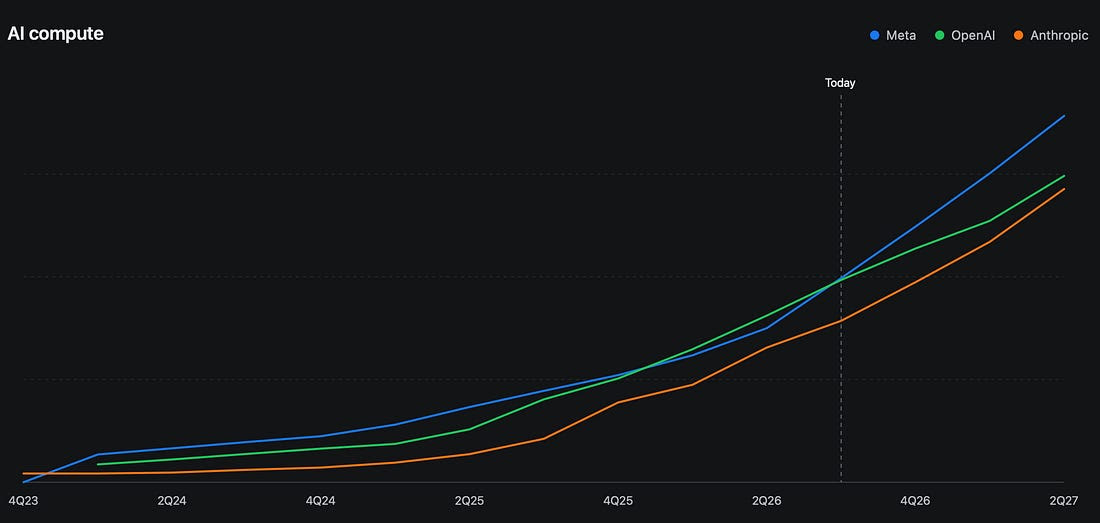
Πηγή: SemiAnalysis Tokenomics Model
Είναι σημαντικό να σημειωθεί ότι ένα ουσιαστικό μέρος αυτής της υπολογιστικής ισχύος θα χρησιμοποιηθεί για συστήματα συστάσεων —RecSys— και παραγωγικές διαφημίσεις. Ωστόσο, ακόμη κι αν παραμείνουμε συντηρητικοί και αποδώσουμε στο MSL μόνο συγκεκριμένες, υψηλού προφίλ τοποθεσίες κέντρων δεδομένων της Meta, η υπολογιστική ισχύς εκπαίδευσής τους παραμένει συγκρίσιμη με εκείνη της OpenAI και της Anthropic για το 2026 και το 2027. Δείτε το πρόσφατο newsletter μας για πιο αναλυτική ανάλυση της στρατηγικής υπολογιστικής ισχύος της Meta και το Tokenomics Model μας για συγκεκριμένους αριθμούς.
Μια πρωτοφανώς μεγάλη αύξηση υπολογιστικής ισχύος με επικεφαλής 5 τιτάνες
Πολλά έχουν γραφτεί για το Colossus και την ικανότητα του Έλον να θέτει γρήγορα σε λειτουργία τεράστιες ποσότητες υπολογιστικής ισχύος. Όμως αυτό που κάνει σήμερα η Meta είναι αναμφίβολα ακόμη πιο εντυπωσιακό, όπως γνωρίζουν εδώ και περισσότερο από έναν χρόνο οι συνδρομητές του Datacenter Industry Model μας.
Η Meta κατασκευάζει ταυτόχρονα πέντε «τιτανικά» clusters άνω του 1 GW. Υπάρχει το Prometheus στο Οχάιο, το Hyperion στη Λουιζιάνα και τρία ανώνυμα campuses στο Ελ Πάσο, στην Αϊόβα και στην Ιντιάνα.
Ποτέ στην ιστορία της ανθρωπότητας δεν έχουμε δει ένα πλήρες campus 1 GW να βρίσκεται ταυτόχρονα υπό κατασκευή — το πλησιέστερο προηγούμενο ήταν η AWS που κατασκεύαζε 800 MW στην Ιντιάνα για το Project Rainier. Και όμως, η Meta έχει αυτή τη στιγμή δύο τέτοια: το Hyperion και την Αϊόβα.
Στο Hyperion, η Meta κατασκευάζει τα μεγαλύτερα ενιαία κτίρια στον κόσμο, ισχύος 400 MW το καθένα. Συνολικά, 1,5 GW βρίσκονται σήμερα υπό κατασκευή: τρία τέρατα των 400 MW, συν τρία ακόμη πιο τυπικά κτίρια των 100 MW.
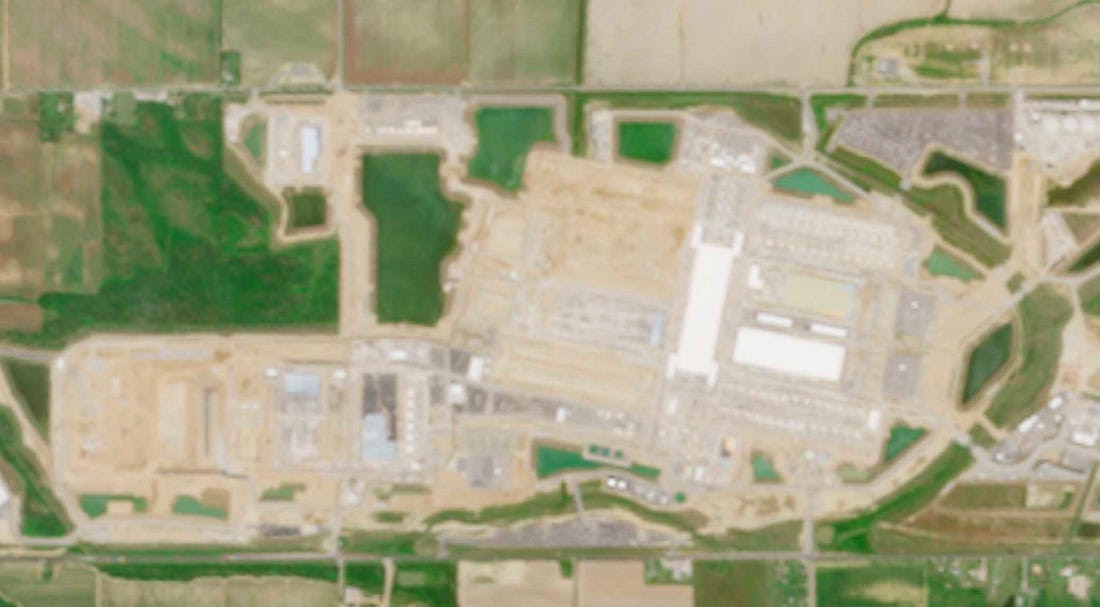
Πηγή: SemiAnalysis Datacenter Model
Στην Αϊόβα, η Meta υπέγραψε μίσθωση 1 GW με κορυφαίο διαχειριστή κέντρων δεδομένων, όπως είχαμε επισημάνει τον Ιούνιο του 2025 στο Datacenter Model μας. Όπως μπορείτε να δείτε από τις παρακάτω δορυφορικές εικόνες, πέρασαν από το μηδέν σε πλήρες GW υπό κατασκευή μέσα σε μόλις έναν χρόνο.
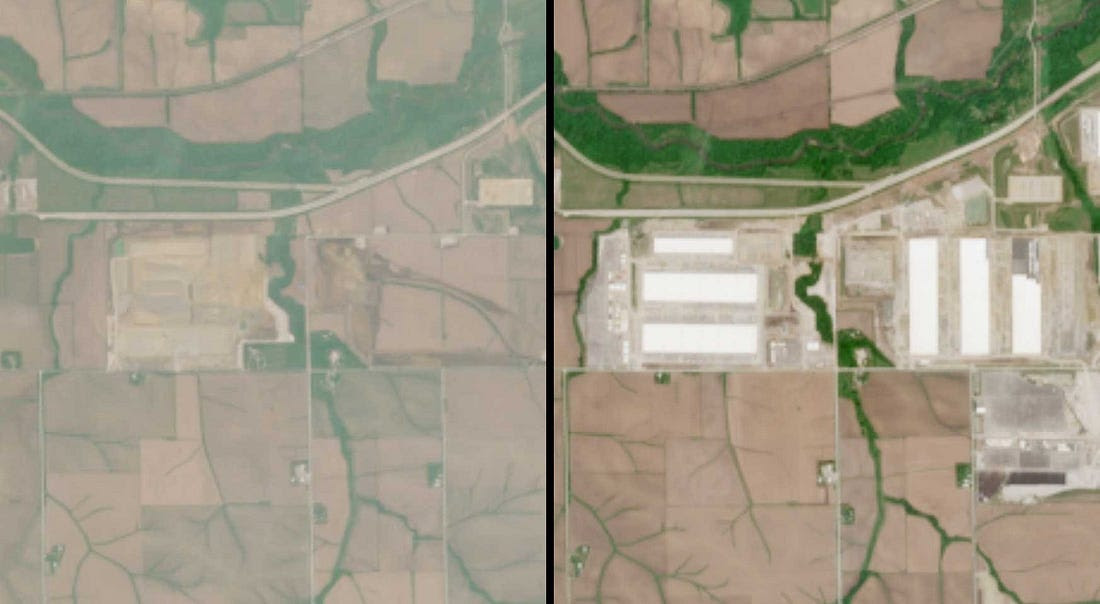
Μάιος 2025 αριστερά έναντι Μαΐου 2026 δεξιά. Πηγή: SemiAnalysis Datacenter Model
Στο Prometheus —το οποίο είναι ήδη σήμερα εν μέρει λειτουργικό— η Meta δεν έχει ακριβώς ένα πλήρες GW υπό κατασκευή αυτή τη στιγμή, αλλά υιοθετεί πλήρως τον πρόχειρο σχεδιασμό κέντρων δεδομένων τύπου «σκηνής», τον οποίο είχαμε επισημάνει στο προηγούμενο άρθρο μας για το MSL. Το cluster Prometheus συνεχίζει επίσης να επεκτείνεται: από ένα αρχικό περίπου 1 GW σε πάνω από 3 GW μέσα σε δύο χρόνια. Για να κατανοήσετε πώς το πετυχαίνει αυτό η Meta, δείτε το Datacenter Model μας. Διαθέτουμε παρακολούθηση σε επίπεδο κτιρίου και για τους πέντε Τιτάνες και είμαστε οι πρώτοι που επισημαίνουμε οποιαδήποτε επέκταση με ακριβή μηνιαία χρονοδιαγράμματα. Ορισμένες από αυτές τις εγκαταστάσεις χρησιμοποιούν ισχύ πίσω από τον μετρητή και παρακολουθούμε τον ακριβή τύπο συστήματος, επισημαίνοντας και τον κίνδυνο αδειοδότησης.
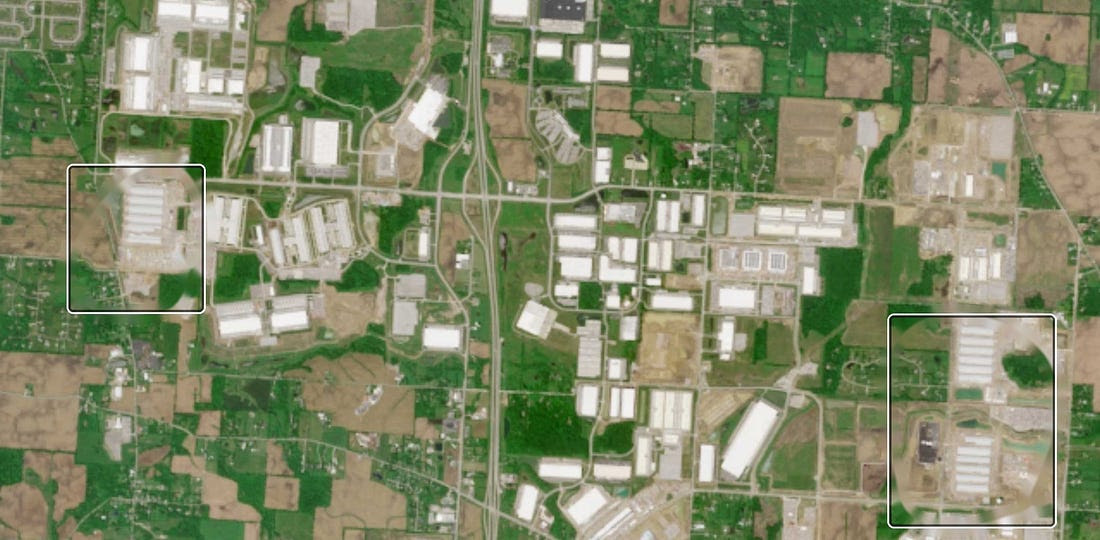
Πηγή: SemiAnalysis Datacenter Model
Σύνδεση των τιτάνων: Η λύση της Meta για το scale-across
Επειδή η Meta κυρίως κατασκευάζει και λειτουργεί τα δικά της κέντρα δεδομένων, έχει μεγαλύτερη ευελιξία να προσαρμόζει την υποδομή της στις πραγματικές της ανάγκες. Το Prometheus είναι ένα καλό παράδειγμα αυτού. Αντί για ένα ενιαίο κέντρο δεδομένων ή campus, το Prometheus είναι ένας αστερισμός 27 κέντρων δεδομένων κατανεμημένων σε 6 campuses. Τα 5 από αυτά βρίσκονται σε απόσταση 6 χιλιομέτρων το ένα από το άλλο και το έκτο απέχει 75 έως 80 χιλιόμετρα από τα υπόλοιπα.
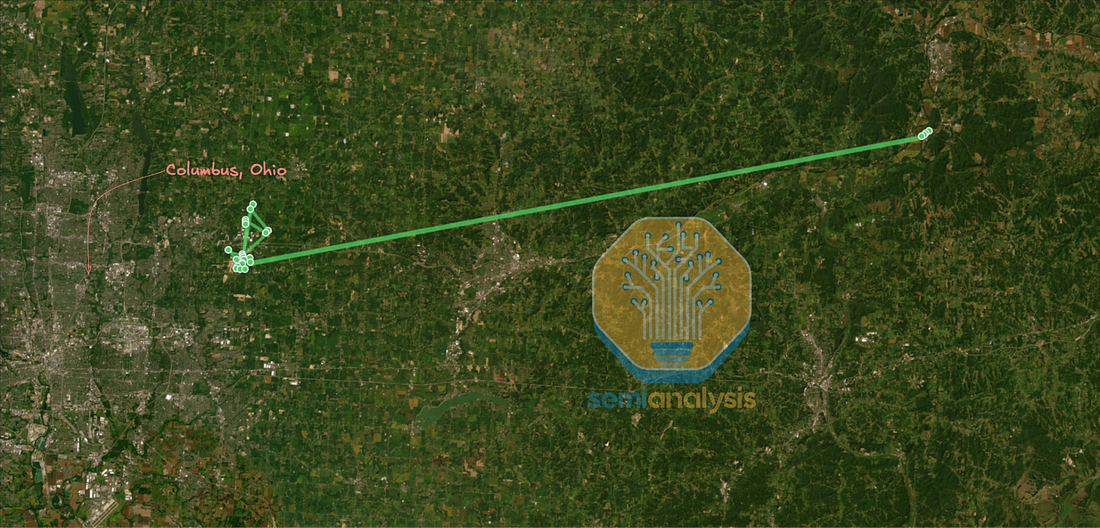
Πηγή: SemiAnalysis AI Networking Model, Meta
Ο λόγος πίσω από αυτή την επιλογή σχεδιασμού είναι ότι η κλιμάκωση σε εκατοντάδες megawatts είναι σήμερα πολύ δύσκολη, ιδίως όσον αφορά τη θερμική διαχείριση και τη διαχείριση ισχύος. Η εκπαίδευση των επόμενων μοντέλων τεχνητής νοημοσύνης αιχμής απαιτεί πολλή υπολογιστική ισχύ — πολύ πέρα από τα 100 MW. Γι’ αυτό η διανομή του φόρτου εργασίας σε πολλαπλά κέντρα δεδομένων είναι ο δρόμος προς τα εμπρός για την υπέρβαση των σημερινών περιορισμών.
Ωστόσο, αυτή η επιλογή σχεδιασμού φέρνει μαζί της μια νέα πρόκληση: τη δικτύωση. Όλο το νόημα ενός μεγαλύτερου cluster είναι να μπορείς να εκπαιδεύεις μεγαλύτερα μοντέλα σε εύλογο χρονικό διάστημα. Αν οι επιταχυντές δεν μπορούν να επικοινωνούν αποτελεσματικά, τότε δεν υπάρχει κανένα νόημα σε ένα campus κλίμακας gigawatt. Εδώ μπαίνει στο παιχνίδι το scale-across.
Για να το αντιμετωπίσει αυτό, η Meta εισήγαγε μια λύση που ονομάζεται AI-Backbone, ή εν συντομία AIBB. Πρόκειται για εξέλιξη του 10X Backbone της, ειδικά σχεδιασμένη για AI και για τις ανάγκες τεράστιων clusters. Αυτή η αρχιτεκτονική δικτύου αποτελείται από πολλαπλά L3 Superspines —ή Backend Aggregation, εν συντομία BAG— που διασυνδέουν έως 5 περιοχές scale-out DSF —Disaggregated Scheduled Fabric— ή 7 περιοχές NSF —Non-Scheduled Fabric—, οι οποίες μπορούν επίσης να συνδυάζονται μεταξύ τους. Τα L3 Superspines στη συνέχεια συγκεντρώνονται σε έναν ενιαίο κόμβο L4 Inter-BAG, ο οποίος έχει σχεδιαστεί να παρέχει περίπου 22 petabits ανά δευτερόλεπτο αμφίδρομου εύρους ζώνης σε ολόκληρο το cluster Prometheus.
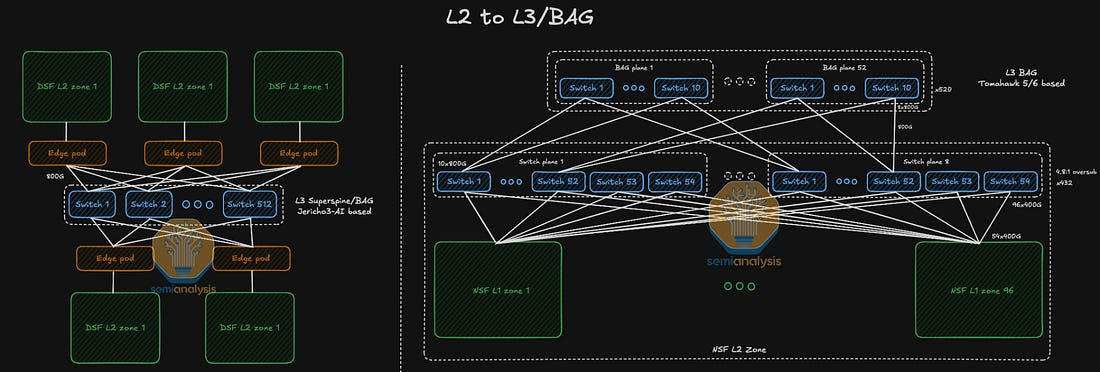
Πηγή: SemiAnalysis AI Networking Model
Ενώ οι περιοχές DSF και NSF χωρούν σε μία μόνο αίθουσα κέντρου δεδομένων, τα επίπεδα L3 και L4 κατανέμονται σε όλα τα κέντρα δεδομένων. Το επίπεδο L3 βρίσκεται μέσα σε ένα ενιαίο campus, ενώ το L4 χρησιμοποιείται κυρίως για τη διασύνδεση των διαφορετικών campuses μεταξύ τους. Η σύνδεση μεταξύ L3 και L4 γίνεται με έναν συνδυασμό LR optics και συστημάτων Dense Wavelength Division Multiplexing —DWDM— με ZR optics, ανάλογα με το μήκος της οπτικής ίνας που απαιτείται για να φτάσει στο άλλο campus.
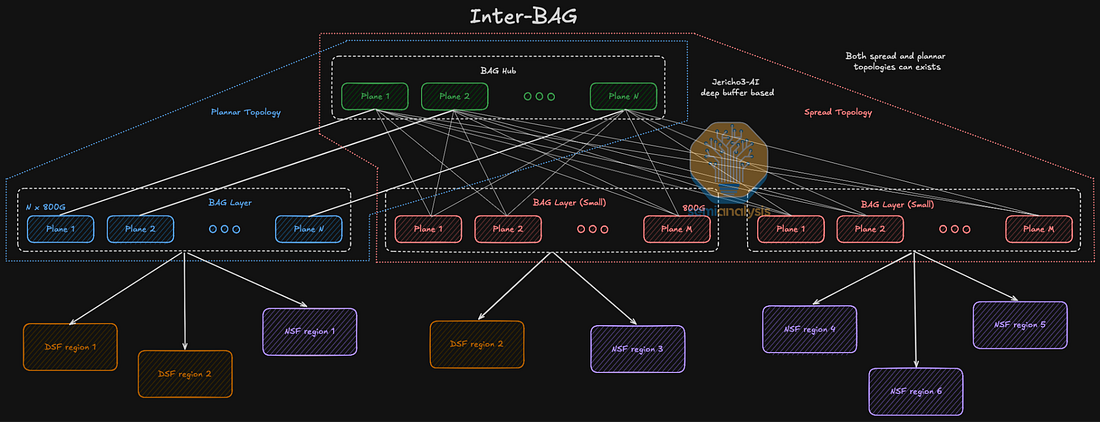
Πηγή: SemiAnalysis AI Networking Model
Αν και αυτό φαίνεται να είναι η τέλεια λύση, αυτή η αρχιτεκτονική δικτύου και η απόσταση μεταξύ των κέντρων δεδομένων εισάγουν εκ των πραγμάτων καθυστέρηση. Μέσα σε μια περιοχή DSF ή NSF, η καθυστέρηση συνήθως κυμαίνεται μεταξύ 1 και 10 μικροδευτερολέπτων, αλλά η καθυστέρηση για να φτάσεις σε μια εγκατάσταση που απέχει 100 χιλιόμετρα δεν μπορεί να είναι μικρότερη από 500 μικροδευτερόλεπτα, απλώς λόγω της διάδοσης του φωτός μέσα στην οπτική ίνα. Αυτό αναγκάζει τη Meta να χρησιμοποιεί ασύγχρονες στρατηγικές για τις ροές εργασίας εκπαίδευσης. Η προεκπαίδευση μπορεί να γίνεται συγχρονισμένα σε μία περιοχή, αλλά η RL μπορεί να κατανεμηθεί παγκοσμίως αρκετά εύκολα.
Συνολικά, ενώ το Prometheus προσφέρει μια λύση στους σημερινούς περιορισμούς, οι άλλοι «Τιτάνες» θα πάνε ακόμη πιο μακριά με το scale-across, συνδέοντας campuses που απέχουν έως και 2.000 χιλιόμετρα μεταξύ τους.
Συγκροτώντας την υπερομάδα του MSL
Πέρυσι, η Meta έγινε διάσημη επειδή πρόσφερε σε ερευνητές τεχνητής νοημοσύνης πακέτα αμοιβών που θα έκαναν τον Patrick Mahomes να ζηλέψει. Αφού ξόδεψε 14 δισ. δολάρια για να αποκτήσει τον Alexandr Wang και ακόμη πάνω από 1 δισ. δολάρια για να εξαγοράσει το venture fund των Nat Friedman και Daniel Gross, αναφέρθηκε ότι η Meta είχε προσελκύσει τουλάχιστον 14 ερευνητές μέχρι τα τέλη Ιουνίου 2025. Οι περισσότεροι από αυτούς προέρχονταν από την OpenAI, αλλά υπήρχαν και ορισμένοι από την Anthropic και την Google. Μερικά μεγάλα ονόματα είναι οι Shengjia Zhao, Trapit Bansal, Joel Pobar και Jack Rae.
Έκτοτε, το MSL συνέχισε την ξέφρενη στρατολόγησή του. Αξιοσημείωτες προσλήψεις σε επίπεδο έρευνας και μηχανικής περιλαμβάνουν:
Andrew Tulloch, πρώην συνιδρυτή της Thinking Machines.
Joshua Gross, Mark Jen, Yinghai Lu, από την ιδρυτική ομάδα της Thinking Machines.
Jason Wei, Hyung Won Chung και Zhiqing Sun, πρώην στελέχη της OpenAI.
Το MSL δεν προσλαμβάνει μόνο τεχνικό προσωπικό. Τον Ιανουάριο προσέλαβε την Dina Powell McCormick —μια καλά δικτυωμένη προσωπικότητα του χρηματοοικονομικού χώρου και πρώην σύμβουλο τόσο του Τραμπ όσο και του Τζορτζ Μπους του νεότερου— ως πρόεδρο και αντιπρόεδρο, για να βοηθήσει στην ανάπτυξη του στόλου υπολογιστικής ισχύος. Στο ίδιο πνεύμα, τον Απρίλιο προσέλαβαν και τους «τρεις σωματοφύλακες» από την ομάδα υπολογιστικής ισχύος της OpenAI —τους Pete Hoeschele, Anuj Saharan και Shamez Hemani— αν και ένας από αυτούς έχει ήδη αποχωρήσει λόγω των πολιτισμικών προβλημάτων της Meta στον οργανισμό υποδομών.
Όπως όταν μια αθλητική ομάδα αρχίζει ξαφνικά να ξοδεύει αφειδώς σε σούπερ σταρ, μόνο ο χρόνος θα δείξει αν αυτή η νεοσυγκροτημένη υπερομάδα της Meta μπορεί πράγματι να κερδίσει το πρωτάθλημα. Ωστόσο, ο Ζακ έχει καταστήσει σαφείς τις προθέσεις του και συγκεντρώνει όλους τους διαθέσιμους πόρους για να κάνει μια πραγματική προσπάθεια στην αιχμή της τεχνητής νοημοσύνης. Σήμερα, δεν μπορεί κανείς να πει το ίδιο για κανέναν άλλον hyperscaler. Αυτό μπορεί να είναι καλό ή κακό για την επιχείρηση της Meta, ανάλογα με τις αρχικές παραδοχές σας, αλλά πιστεύουμε ότι έχει τις καλύτερες πιθανότητες να καλύψει τη διαφορά με την Anthropic και την OpenAI.
Αλλά, για να είμαστε σαφείς, η επιτυχία κάθε άλλο παρά εγγυημένη είναι
Είμαστε συνολικά αισιόδοξοι για το μέλλον του MSL, αλλά αξίζει να τονιστεί ότι εξακολουθούν ουσιαστικά να βρίσκονται στο πρώτο βήμα. Τους αναγνωρίζουμε ότι συγκέντρωσαν τους πόρους και το θάρρος που απαιτούνται για να κάνουν μια πραγματική προσπάθεια οικοδόμησης RSI, αλλά τώρα πρέπει να κάνουν την πραγματική δουλειά. Το να φτάσεις την Anthropic είναι ευκολότερο στα λόγια παρά στην πράξη, και, στο τέλος της ημέρας, η Meta εξακολουθεί να είναι μια μεγάλη τεχνολογική εταιρεία με πολλές ανταγωνιστικές απόψεις και προτεραιότητες.
Όπως εξηγήσαμε στο πρόσφατο κείμενό μας για την υπολογιστική ισχύ της Meta, υπάρχουν πολλοί τρόποι με τους οποίους η Meta μπορεί να εμπορευματοποιήσει προσωρινά την υπολογιστική ισχύ βραχυπρόθεσμα, διατηρώντας παράλληλα τη δυνατότητα να τα δώσει όλα στο MSL, αν ο ερευνητικός της οργανισμός πετύχει τα σωστά ορόσημα. Ωστόσο, αν κάνει οτιδήποτε δείχνει πραγματική εξασθένηση της αποφασιστικότητάς της —όπως να υπογράψει μακροπρόθεσμη συμφωνία πώλησης υπολογιστικής ισχύος χωρίς δυνατότητα ανάκλησης, να διαλύσει τον νέο οργανισμό δημιουργίας εργασιών RL ή να αφήσει τους κορυφαίους ερευνητές της να φύγουν— τότε θα γινόμασταν ουσιαστικά λιγότερο αισιόδοξοι. Θα μπορούσε μάλιστα να υποστηρίξει κανείς ότι οποιαδήποτε από αυτές τις κινήσεις θα ισοδυναμούσε με θανατική καταδίκη για το MSL.
Δοκιμάσαμε για λίγο το Muse Spark 1.1 πριν από την επίσημη κυκλοφορία του και πιστεύουμε ότι βρίσκεται περίπου στο ίδιο επίπεδο με το Opus 4.6 ή το GLM 5.2 για γενικές agentic χρήσεις. Το γεγονός ότι η Meta επέλεξε να τιμολογήσει το μοντέλο λίγο κάτω από το GLM 5.2 φαίνεται σκόπιμο. Ορισμένοι από τους μηχανικούς μας παρατήρησαν ότι έχει την κακή συνήθεια να αγνοεί προειδοποιήσεις αντί να τις διορθώνει και ότι δεν χρησιμοποιεί σωστά το εργαλείο επεξεργασίας.
Κανένας από τους εσωτερικούς μας όγκους tokens δεν θα μετακινηθεί στο Muse Spark 1.1, αλλά αυτό είναι ακόμη αναμενόμενο σε αυτό το στάδιο. Ακόμη και στο αισιόδοξο σενάριο, δεν περιμένουμε να φτάσουν την Anthropic ή την OpenAI πριν από το τέλος του έτους.